agentic-data-analyst
Fragen Sie Ihre Daten im Chat: Claude schreibt lesendes DuckDB-SQL, ein zweiter Agent prüft es, und deterministische Guardrails sowie Kostenbudgets begrenzen jede Abfrage – Antworten, Tabellen und Diagramme in Chainlit.


Öffentliche Fallstudien
Sechs Open-Source-Repositories und ein laufendes KI-Forschungslabor – nachprüfbare Belege dafür, wie ich Data Engineering, Machine Learning, Umsetzung und Betrieb angehe.
Open-Source-Repositories
Fokussierte Bibliotheken, entstanden aus wiederkehrenden Problemen in Kundenprojekten – abgesicherte Analytics-Agenten, Datenqualität, Experimente und Messdaten aus der Fahrzeugentwicklung –, dazu die Engine und das Template hinter Retro Speedlab.
Fragen Sie Ihre Daten im Chat: Claude schreibt lesendes DuckDB-SQL, ein zweiter Agent prüft es, und deterministische Guardrails sowie Kostenbudgets begrenzen jede Abfrage – Antworten, Tabellen und Diagramme in Chainlit.
Typisierte, Spark-native Validierung und Profilierung der Datenqualität, die kompatible Prüfungen in einem einzigen Aggregationsdurchlauf zusammenfasst.
Eine typisierte Bibliothek für A/B-Experimente mit Inferenz, Diagnose von Sample Ratio Mismatch, Poweranalyse und Korrektur für multiples Testen.
Ein Apache-Spark-DataSource-V2-Connector für die verteilte Analyse von ASAM-MDF4-Fahrzeugmessdaten, mit Filter-Pushdown bis in die Datei.
Die Engine hinter dem Labor: Go-Explore und Baumsuche über Emulator-Save-States, gelenkt von einer PPO-Policy und einer aus einem TAS-Video gelesenen Routenkarte; jeder Lauf wird ab dem Einschalten bildgenau verifiziert.
Ein Cookiecutter-Template für Spielpakete: ein Grundgerüst, das nichts über sein Spiel weiß, bis geplante Claude-Code-Laborläufe es ausbauen.
Warum es das gibt
Ein Großteil meiner Arbeit findet in Kundenumgebungen statt und ist durch Geheimhaltungsvereinbarungen geschützt. Retro Speedlab bietet eine bescheidene, transparente Alternative: ein echtes System, das öffentlich eingesehen, genutzt und kritisch geprüft werden kann.
Das Labor stellt eine klar umrissene Frage: Wie schnell kann eine KI Snake Rattle ’n’ Roll ohne Warps ab dem Einschalten durchspielen? Die Antwort verbindet zwei Disziplinen, die Unternehmen zunehmend gemeinsam brauchen. Die Engine durchsucht Emulator-Save-States in parallelen Emulatoren, gelenkt von einer PPO-Policy, die lernt, welche Tasten wirken, und von einer Routenkarte, die aus einem Referenzvideo eines Tool-Assisted Speedruns gelesen wird. Ein neuer Abschnitt des Laufs zählt erst, wenn er sich ab dem Einschalten bildgenau abspielen lässt – alles auf einem Desktop-PC von 2017 mit einer RTX 2070. Kommt die Suche nicht weiter, verbessert ein zeitgesteuertes Team aus Claude-Code-Agenten das Spielpaket, und ein zweiter Claude-Agent hält die Plattform selbst am Laufen.
Das spielerische Thema macht das Experiment zugänglich; die Technik dahinter ist dieselbe, die ich in Kundensystemen einsetze.
Alles geschieht öffentlich: Der Lauf wird live auf Twitch gestreamt, und jeder Laborbericht und jeder Rekord wird auf der Website des Labors veröffentlicht.
Es soll weder Größe noch Rahmenbedingungen eines Enterprise-Projekts ersetzen. Es macht lediglich die Arbeitsweise sichtbar: das Problem eingrenzen, den gesamten Weg bauen, wiederkehrende Abläufe automatisieren, messen, was läuft, und die Hoheit über Code und Daten behalten.
Zwei Disziplinen, ein System
Suche und Reinforcement Learning finden den schnellsten Lauf; Agentic Engineering verbessert fortlaufend das System darum herum. Das Labor betreibt beides produktiv – unter den Bedingungen, die auch Kunden kennen: begrenzte Hardware, unbeaufsichtigter Betrieb und die Pflicht, jedes Ergebnis zu verifizieren.
Die schnellsten Eingaben für ein NES-Spiel ab dem Einschalten finden – auf einem Desktop-PC von 2017.
Für Kunden: Suche, Lernen und strenge Verifikation, die ein messbares Ergebnis auf Hardware optimieren, die ein Unternehmen bereits besitzt – jedes Experiment nachverfolgt in Weights & Biases.
Claude in einen verlässlichen, unbeaufsichtigten Entwicklungsprozess verwandeln – mit eingebauter Evaluation und Observability.
Für Kunden: Agenten, die innerhalb definierter Grenzen auf echten Systemen handeln, an Ergebnissen gemessen werden und für jede Änderung einen Trace und einen Audit-Trail hinterlassen.
Einblick ins Produkt
Die Website speist sich aus dem Lauf selbst: dem Livestream, den Laborberichten und der Methode dahinter. Es handelt sich um echte Ansichten des Labors, nicht um Präsentations-Mock-ups.
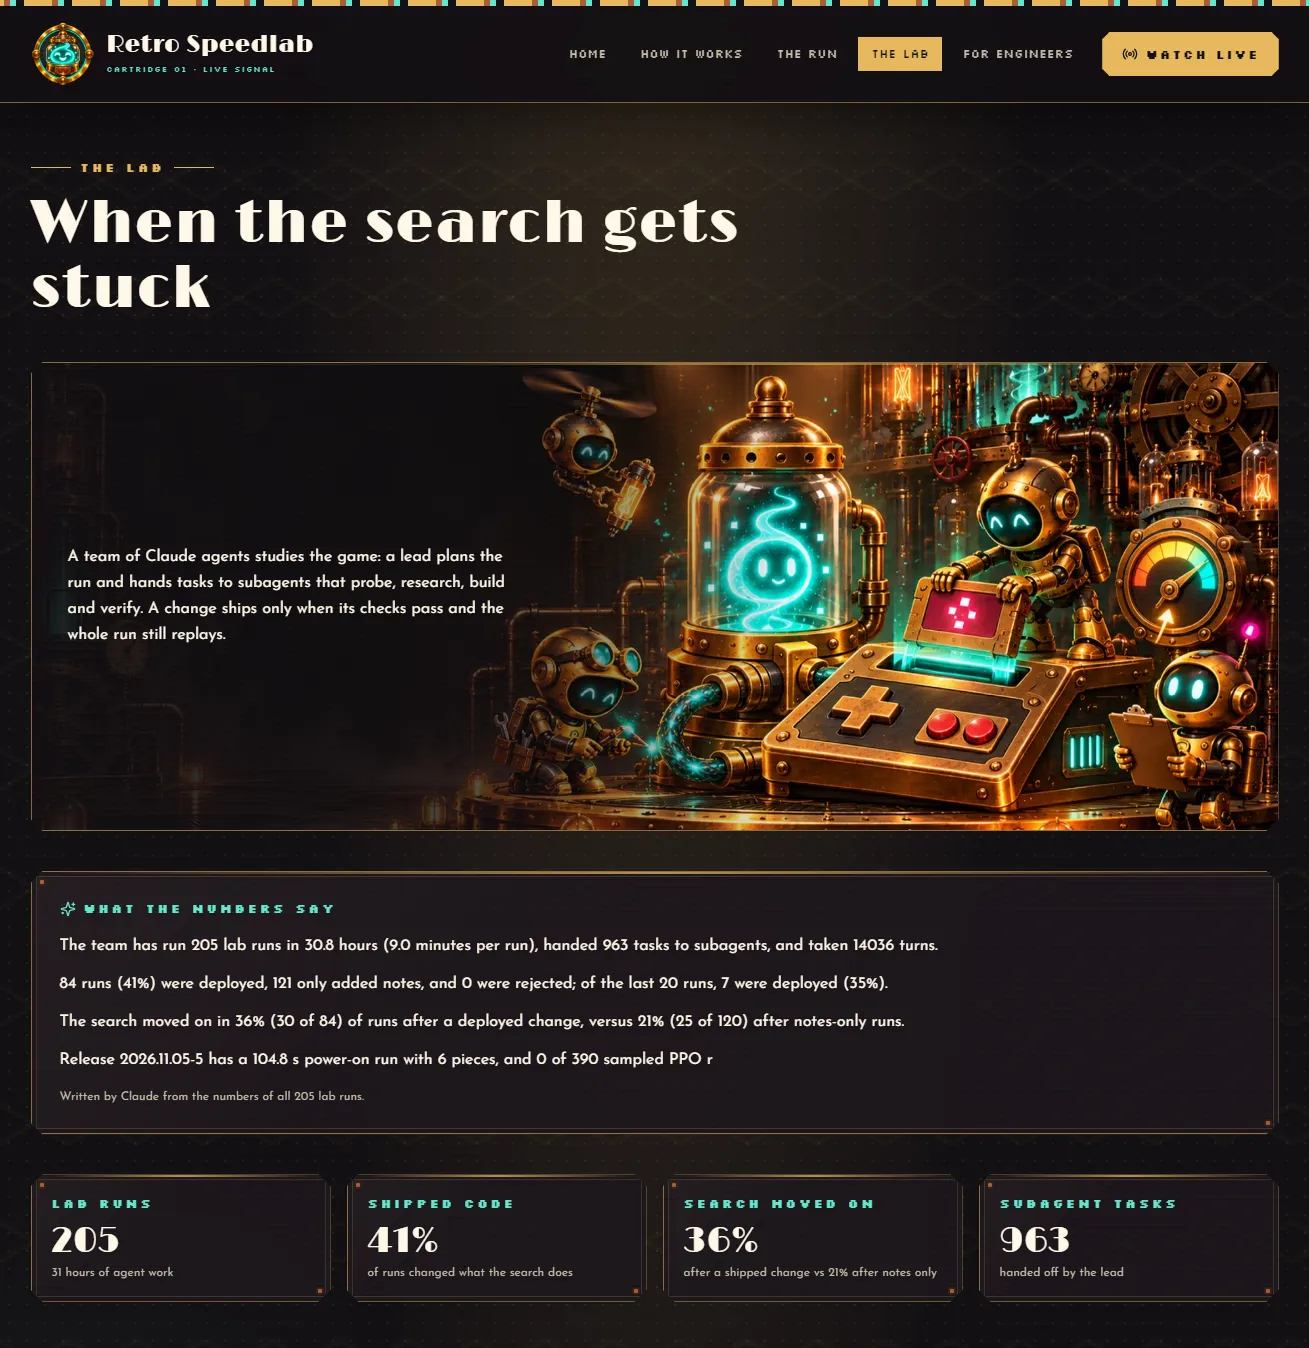
Die Laborseite zeigt, was die Claude-Agenten getan haben: Laborläufe, ausgelieferte Änderungen, Subagenten-Aufgaben und wie oft die Suche danach vorankam.
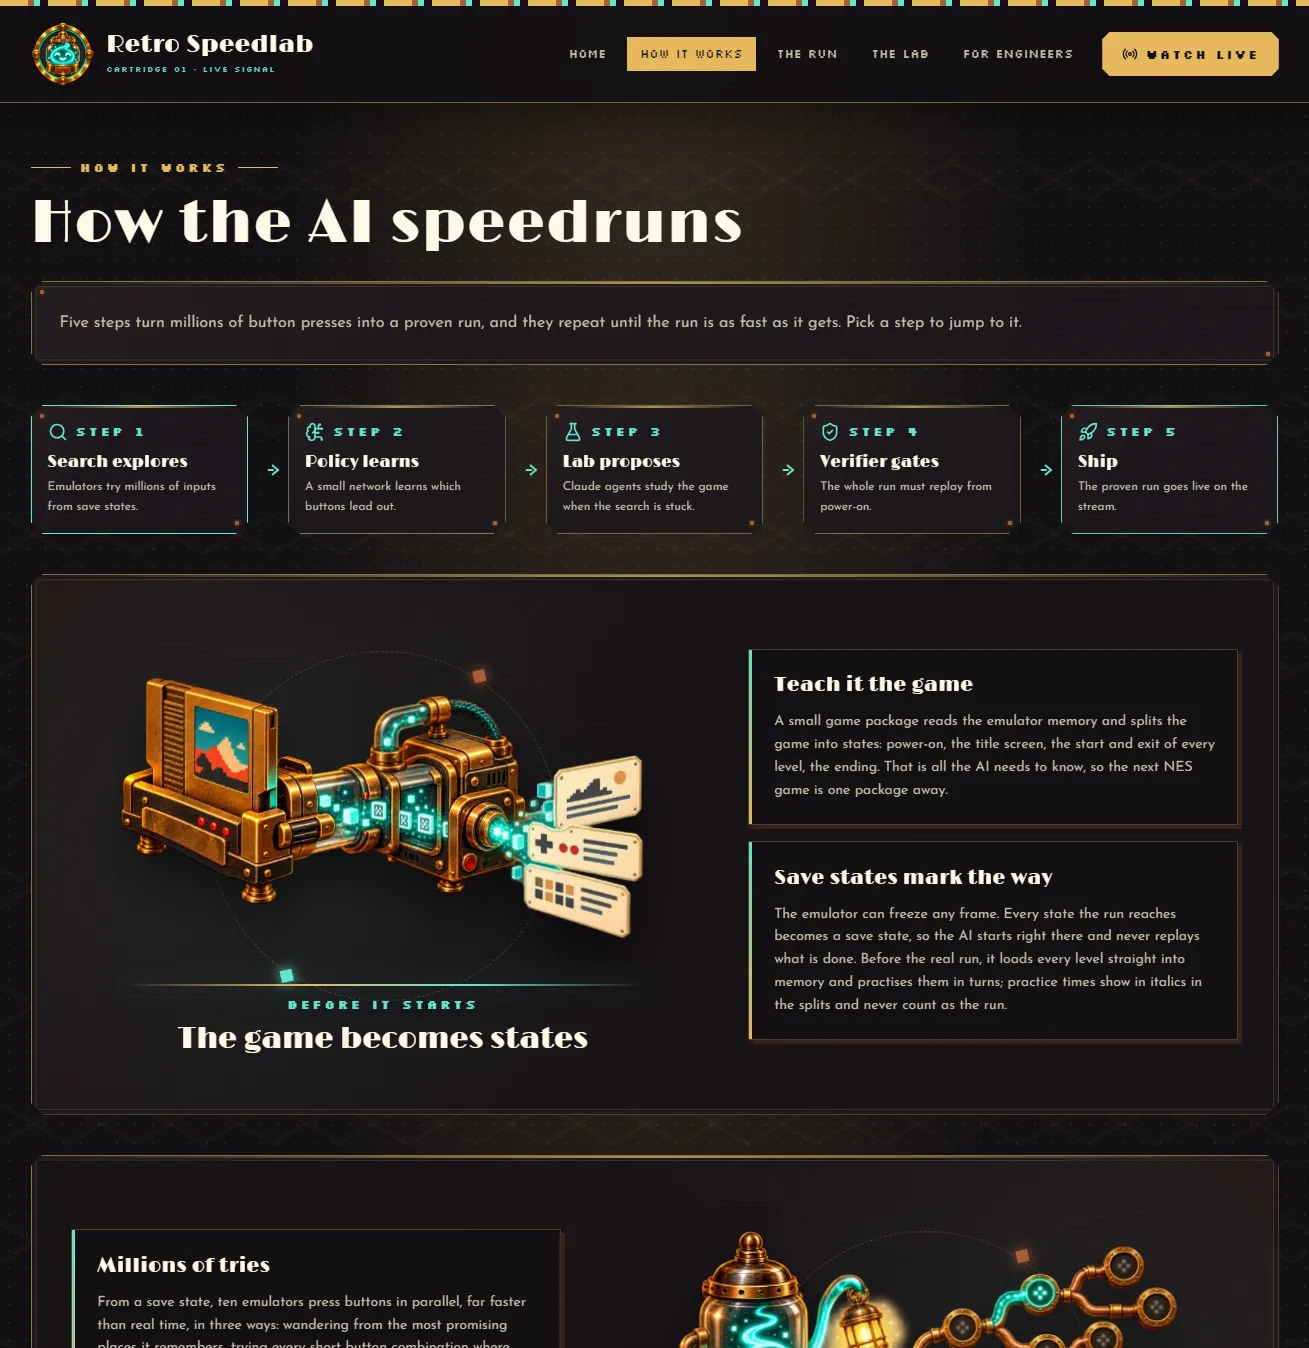
Fünf Schritte erklären, wie die Suche erkundet, die Policy lernt, das Labor Vorschläge macht, der Verifier prüft und der bewiesene Lauf veröffentlicht wird.
Durchgängiges System
Jede Stufe ist verbunden, automatisiert und einzeln nachprüfbar. Flyte-Workflows betreiben Speedrun und Labor unbeaufsichtigt – auf portablen, offenen Komponenten statt unnötiger Plattformabhängigkeit.
Was es zeigt
Der Wert dieser Fallstudie liegt nicht in einem polierten Konzeptpapier, sondern in der Verbindung von Forschungsfrage, Suche und Lernen, autonomen Agenten und laufendem Betrieb.
Eine eng gefasste Frage, öffentlich beantwortet: wie schnell eine KI ein NES-Spiel ab dem Einschalten auf einem Desktop-PC von 2017 durchspielt.
Jedes Release wird in Weights & Biases nachverfolgt – geschaffte Level, eingesparte Frames, Stunden seit dem letzten Fortschritt –, und jeder Laborlauf wird danach bewertet, ob die Suche vorankam.
Agenten arbeiten unbeaufsichtigt hinter klaren Gates: Die Tests müssen bestehen, das Movie muss weiterhin ab dem Einschalten ablaufen, und jeder Lauf hinterlässt einen Trace und einen Bericht.
Eine Vue-3-Website und ein Stream-Overlay auf FastAPI und PostgreSQL, Twitch-Chatbefehle mit „Ask the AI“ und ein Discord-Bot, der Rekorde und Laborläufe postet.
Docker und Dokku auf einem Hetzner-Server und einem Heimserver, selbst gehostetes Bugsink und Umami sowie ruff und pyright im Strict-Modus in der CI.
Claude schreibt den Stream-Kommentar und die Laborbericht-Karten; jede Eingabe im Lauf stammt aus der Suche und einer gelernten Policy, bewiesen durch Wiedergabe.
Belege erkunden
Die Seite für Engineers listet jede Komponente auf – vom Desktop-PC zu Hause bis zur Website – und zeigt, wie gut die Agenten arbeiten, gemessen über alle Laborläufe.